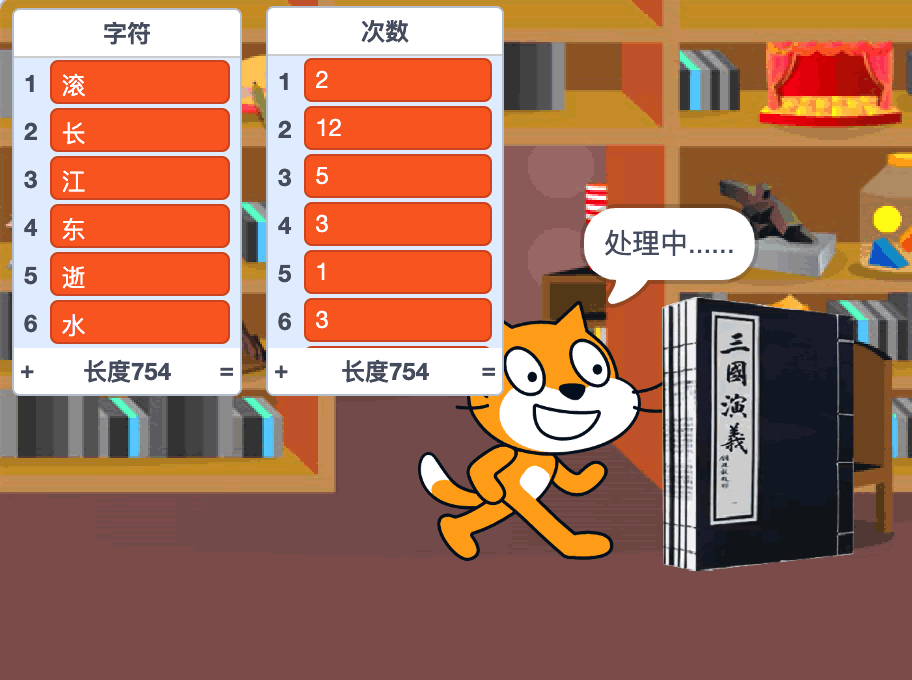
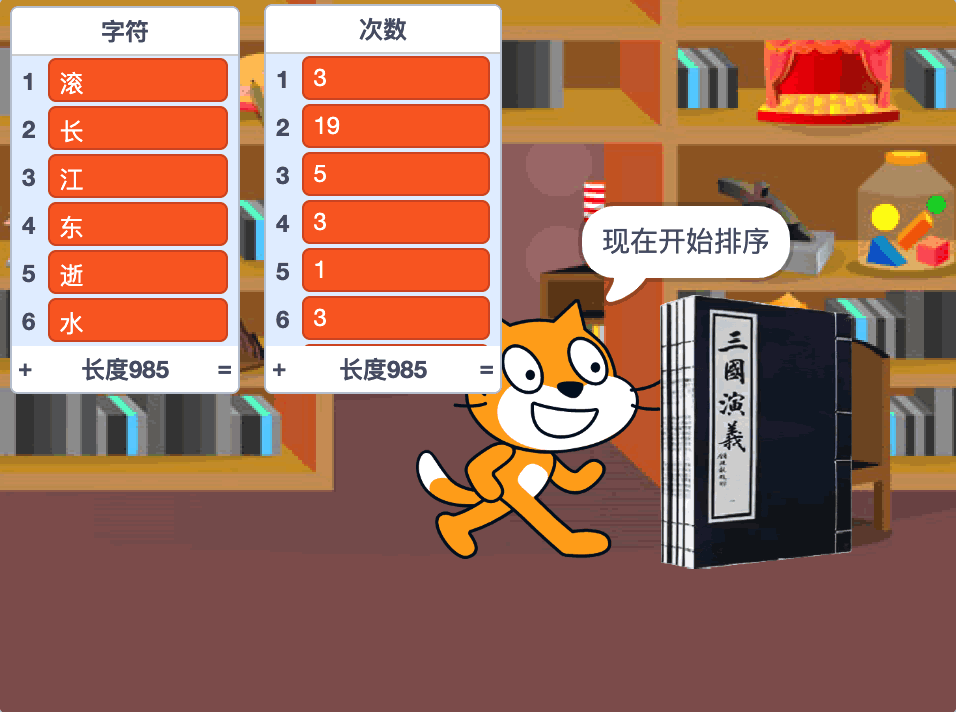
统计字符串 题目说明 背景信息: 《三国演义》是元末明初小说家罗贯中创作的长篇章回体历史演义小说,与《西游记》、《水浒传》、《红楼梦》并称为中国古典四大名著。 编程实现: 对《三国演义》第一回原文进行数据处理,统计出现次数最多的5个汉字。 提示: 编程环境中已经预制一个列表名为“三国演义原文”,如下图所示,其中第一项存储着三国演义第一回文字。请注意务必不要删除这个列表。 具体要求: 1). 点击绿旗,小猫说“我要开始处理了!”2秒; 2). 出现字符列表和次数列表,开始对三国原文进行处理,同时小猫一直说:“处理中......”(处理中不需要对文字使用数量进行排序); 3). 等数据处理完毕后,小猫说:“现在开始排序”2秒; 4). 次数列表中的数据按照从大到小的顺序进行排序(同时保证汉字与次数的数据一一对应),同时小猫说:“正在处理中”; 5). 将出现最多的五个汉字与次数保存在列表中,同时将剩余的汉字与次数从列表中删除; 6). 等待1秒后,小猫说:“处理完毕”2秒,程序终止。
答案解析
评分标准:
5分:满足“具体要求”中的1);
20分:满足“具体要求”中的2);
5分:满足“具体要求”中的3);
20分:满足“具体要求”中的4);
25分:满足“具体要求”中的5);
5分:满足“具体要求”中的6)。
思路分析
这是一道和字符串处理相关的题目,主要包括如下4个功能:
1). 循环读取字符串中的汉字
2). 统计每个汉字的个数,并存入列表
3). 对列表进行排序
4). 保留列表的前5项
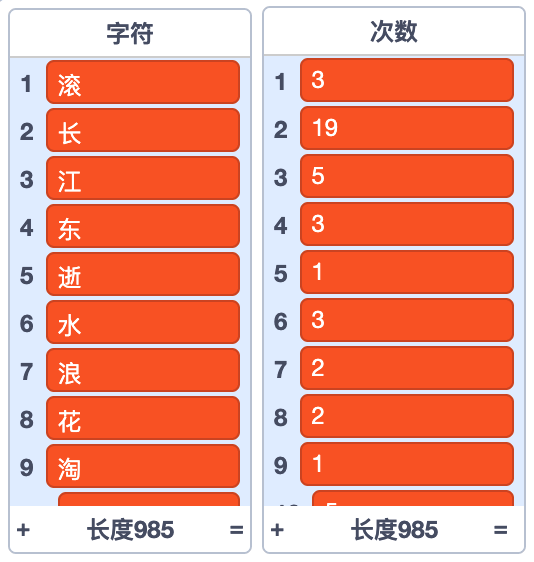
其中,统计汉字个数和列表排序是难点,由于Scratch列表的局限性,在统计汉字个数时,需要使用两个列表,一个用于保存汉字,一个则用于保存汉字对应的个数,二者一一对应,具有相同的编号,如图所示:

其基本思路是这样的,每读取一个汉字,需要判断一下是否已经在在列表中了,如果是,则找到该汉字对应的编号,然后在次数列表中,将对应编号的次数增加1;如果为否,则将汉字追加到字符列表中,同时在次数列表中追加次数1。
当所有的汉字统计完成后,需要进行列表排序,主要是对次数列表按照从大到小的顺序进行排序,并对字符列表进行同步操作。关于排序,是编程中最基础的算法,常见的排序有冒泡排序、选择排序、插入排序和快速排序等。
其中,选择排序相对要简单一些,可以作为我们的首选,其基本思想是:首先在未排序的数列中找到最小(或者最大)元素,然后将其存放到数列的起始位置;接着,再从剩余未排序的元素中继续寻找最小(或者最大)元素,然后放到已排序序列的末尾。以此类推,直到所有元素均排序完毕。
其排序过程可以参考下图:

为了简化代码的结构,我们可以使用函数的编程思想,将独立的功能定义为自制积木,比如统计字符、排序及删除列表数据项。然后可以采取模块化的编程思想,即先整体后局部的策略来编写程序,即先实现作品的完整流程,再逐个实现具体的细节。
试卷来源:202204(第13届)蓝桥杯Scratch图形化编程青少组(省赛_中级)真题